
今天要消除的臭味:Agent 成功一次,團隊就把它當成可靠。
一場常見的 Agent Demo 長這樣:
讀取需求 → 修改程式 → 執行測試 → 全部通過
畫面很漂亮,卻少了幾個關鍵資料:
Demo 證明「曾經成功」。上線需要知道「通常如何完成」。
假設 Agent 單次成功率是 70%,三次嘗試至少成功一次的機率是:
pass@3 = 1 - (1 - 0.7)³ = 97.3%
三次執行全部成功的機率則是:
pass^3 = 0.7³ = 34.3%
pass@3 適合從多個候選結果挑一個最佳答案。日常流程更在意連續成功,因此需要觀察完整執行紀錄。
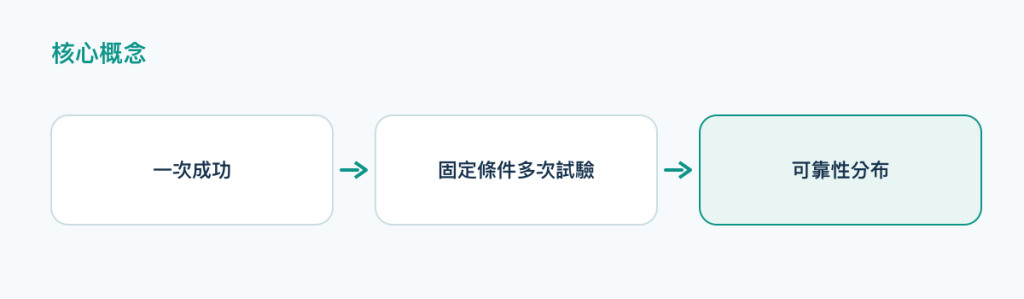
核心概念:一次成功 → 固定條件多次試驗 → 可靠性分布
先定義完成條件,再執行 Agent。以 User API 的 Email 唯一性為例:
| 完成條件 | 結果 |
|---|---|
| API 攔截重複 Email | PASS/FAIL |
| 資料庫具備唯一性約束 | PASS/FAIL |
| 新增重複 Email 測試 | PASS/FAIL |
| 既有測試全部通過 | PASS/FAIL |
| 沒有修改無關檔案 | PASS/FAIL |
接著把同一個任務,在固定環境執行三次:
實驗名稱:
Task 版本:
Prompt 版本:
Repository Commit:
Model/Harness:

Run 1:PASS/FAIL
未達條件:
人工介入:_次
重試:_次
耗時:_分鐘

Run 2:PASS/FAIL
未達條件:
人工介入:_次
重試:_次
耗時:_分鐘

Run 3:PASS/FAIL
未達條件:
人工介入:_次
重試:_次
耗時:_分鐘

完整成功:_/3
主要失敗模式:
每次執行固定以下條件:
人工提醒、人工判斷與重試都要記錄。Agent 最後完成任務,總成本仍包含這些協助。
Agent 替報表流程計算訂單總額。Demo 使用乾淨資料,結果正確。實際資料加入缺少日期、重複訂單與跨時區紀錄後,Agent 漏算一筆。
把三類資料加入固定 Fixture,重跑三次:
Run 1:PASS
Run 2:PASS
Run 3:FAIL,漏算跨時區訂單

可靠性:2/3
這份結果直接指出下一個工程問題:補上跨時區案例與驗證規則,再重跑計分卡。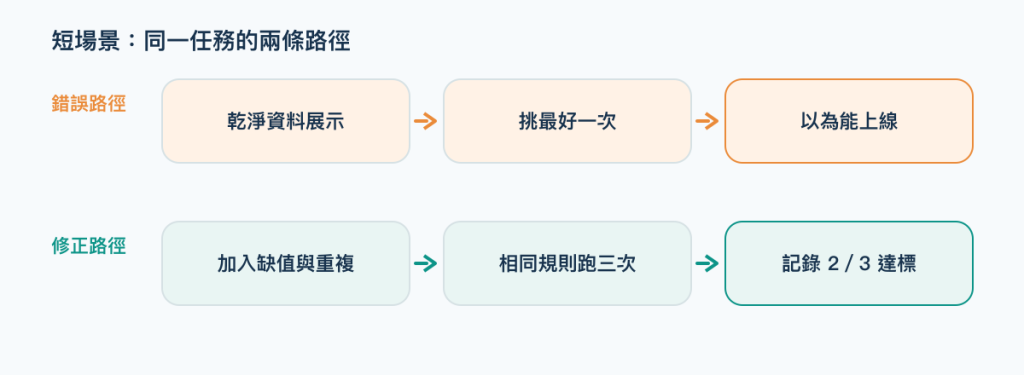
短場景對照:以為能上線與記錄 2/3 達標
Demo 證明 Agent 曾經做得到;可靠性計分卡讓團隊看見它通常做得如何。


 iThome鐵人賽
 看影片追技術